機械学習モデルを作るには――開発の基本的な流れと実用化まで
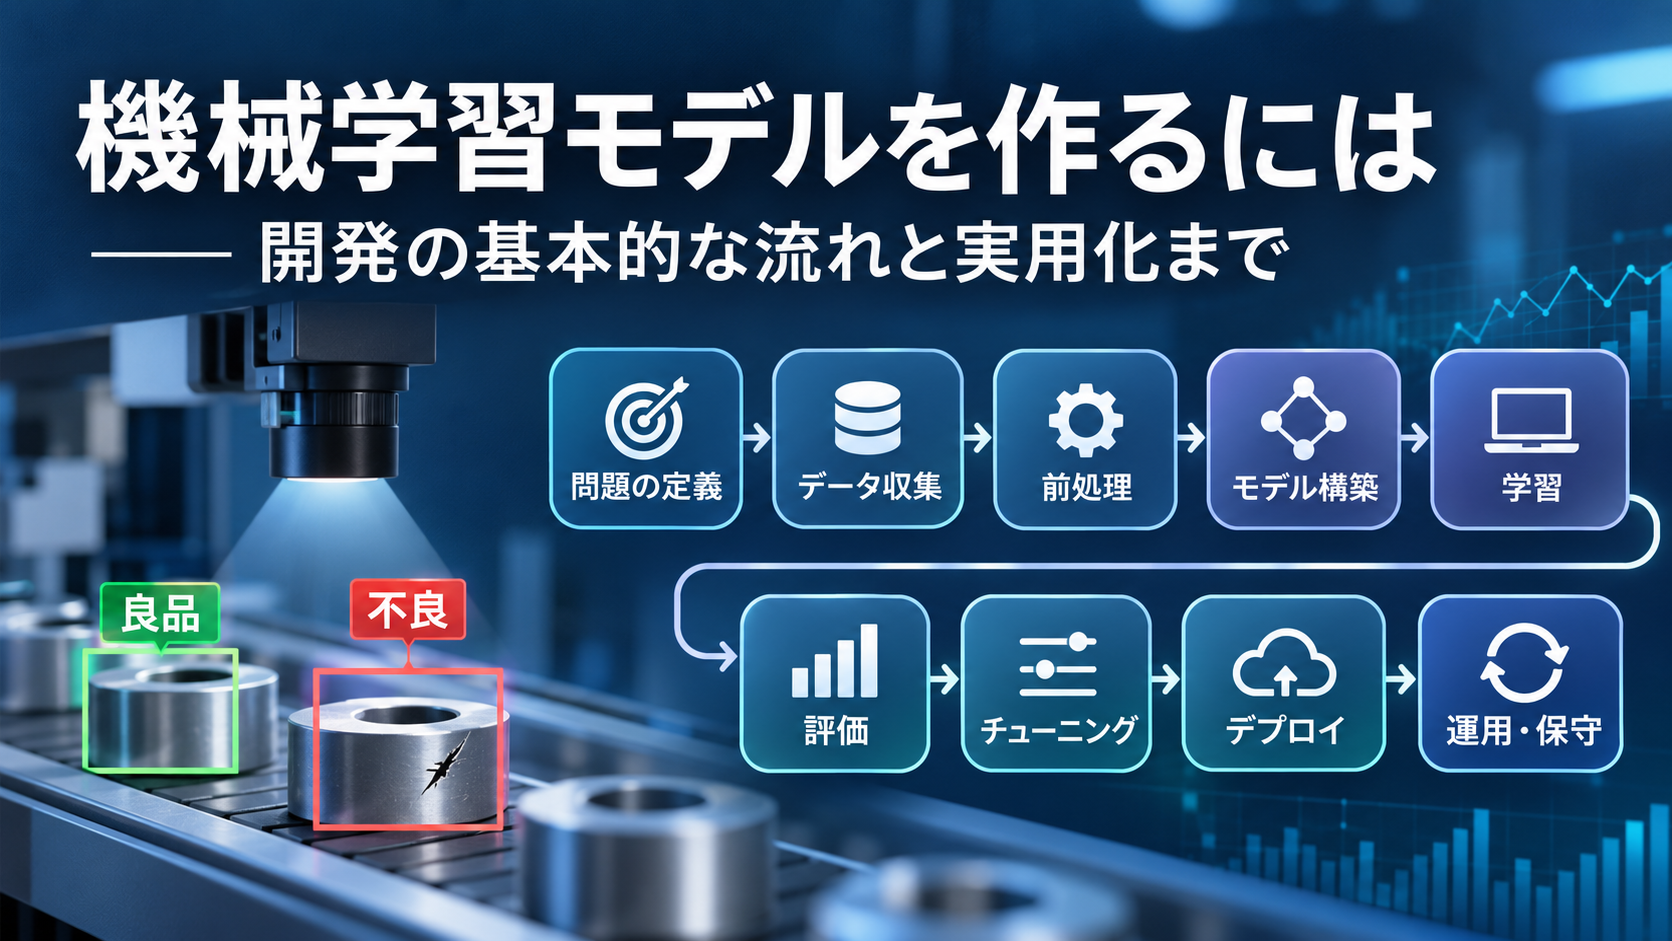
機械学習を使えば、画像から不良品を見つけたり、過去の販売実績から需要を予測したりできる。しかし、データを集めて学習を実行するだけで、現場で役立つ仕組みが完成するわけではない。何を解決するのかを定め、適切に評価し、運用後も性能を確認する必要がある。
本記事では、機械学習モデルの開発を9つの工程に分けて説明する。主に、製品画像と良品・不良品の判定結果を使う「教師あり学習」を例とし、準備から実用化、保守までの流れを整理する。工程は一直線に進むものではなく、評価結果を受けてデータ収集や問題設定に戻ることもある。
機械学習とは何か
機械学習は、データから規則性や関係を学び、予測や分類などに利用する技術であり、AIを実現するための方法の一つである。従来のプログラムでは人が判定条件を記述するのに対し、機械学習では、データを使って判定に必要な関係をモデルに学習させる。
代表的な方法には、入力と正解の組を使う「教師あり学習」、正解ラベルを使わずにデータのまとまりや構造を探る「教師なし学習」、行動の結果として得られる報酬をもとに行動方針を学ぶ「強化学習」がある。分類や数値予測、顧客のグループ分け、制御など、目的に応じて方法が異なる。
なお、これらが機械学習のすべてではなく、自己教師あり学習などの方法もある。また、学習済みモデルはシステムの一部である。撮影装置、データの受け渡し、操作画面、人による確認などを組み合わせて、初めて業務で使える仕組みになる。
1.問題の定義――何を、どこまで解決するのか
最初に決めるべきことは、使用するアルゴリズムではなく、解決したい課題である。「検査にAIを使う」では曖昧であり、「製品表面の傷を画像で検出し、確認が必要な製品を検査担当者に提示する」といった形で、入力、出力、利用場面を具体化する。
あわせて、検出対象となる傷の種類や大きさ、許容できる見逃し、処理時間、人が再確認できる件数などを定める。見逃しを減らしても、良品まで大量に不良品と判定すれば、確認作業が増えて現場が回らなくなる。成功基準は業務上の影響を踏まえて決める必要がある。
明確な寸法や色のしきい値だけで安定して判定できるなら、通常のプログラムや画像処理で十分な場合もある。まず既存の方法を比較基準とし、機械学習を導入することで得られる効果と、開発・運用の負担を比較する。
2.データの収集――量だけでなく、現場を代表しているか
不良品検査の教師あり学習では、製品画像と、その画像が良品か不良品かを示す正解ラベルを用意する。必要なデータ量は、課題の難しさ、製品のばらつき、モデルの種類、目標性能によって変わるため、「何枚あれば十分」と一律には決められない。
重要なのは、実際の使用条件を含むことである。同じ製品でも、照明、撮影角度、背景、製造ロットによって見え方が変わる。良品画像ばかり集めても、不良品の特徴を十分に学べるとは限らない。不良の種類や発生頻度、撮影条件を記録し、不足する事例を把握する。
ラベル付けの基準も統一する。担当者ごとに傷の判定が異なれば、モデルが学ぶ正解自体が揺らいでしまう。判断が難しい画像の扱いを決め、必要に応じて複数人で確認する。外部データを使う場合には利用条件を確認し、個人情報や機密情報を含むデータは、収集・保管・利用の範囲を事前に整理する。
3.データの前処理――学習前の準備と情報漏れへの注意
前処理では、画像サイズや形式の統一、破損データの確認、欠損値への対応、数値の標準化、特徴量の作成などを行う。必要な処理はモデルによって異なり、すべてのデータに同じ処理を行えばよいわけではない。外れ値も、異常そのものを表している場合があるため、機械的に削除しない。
評価のため、データは「学習用」「検証用」「テスト用」に分けて扱う。学習用はモデルを学習させるため、検証用はモデルや設定を選ぶため、テスト用は選定後の性能を最終確認するために使う。分割比率に万能な正解はなく、不良品の件数や評価の目的も考慮する。
平均値や標準偏差を使う標準化など、データから処理の設定を求める前処理は、分割後の学習用データだけで設定を求め、検証用・テスト用にはその設定を適用する。評価用データの情報が学習や選定に入り込む「データリーク」を防ぐためである。
同じ製品を連写した画像や、元画像を加工して増やした画像が別々の集合に混ざると、性能を過大評価しやすい。製品単位で分け、画像の水増しは分割後の学習用データに行う。将来のデータを予測する課題では、時間順の分割も検討する。
4.モデルの選択・構築――複雑さより課題との適合
モデルには、線形回帰、ロジスティック回帰、決定木、ランダムフォレスト、ニューラルネットワークなどがある。数値を予測するのか、分類するのか、どのような入力を使うのかによって候補を選ぶ。複数のアルゴリズムを必ず組み合わせる必要はない。
まず簡単なモデルで比較基準となる性能を確認し、複雑なモデルを使う必要があるか判断する。画像を直接扱うならニューラルネットワークが候補になる一方、面積や色などの特徴量で判定できるなら、別の方法で十分なこともある。説明のしやすさや推論時間も選定条件となる。
画像分野では、既存の学習済みモデルを利用する転移学習も有効な選択肢である。学習済みの特徴抽出部分を利用したり、一部の重みを追加学習で調整したりすることで、一から学習する場合より少ないデータで対応できることがある。ただし、対象画像との違いや利用条件を確認し、実際のデータで評価する必要がある。
5.モデルの学習――未知のデータに対応できるか
学習は、データに合わせてモデルのパラメータを求める過程である。例えばニューラルネットワークでは、予測と正解の違いを損失関数で数値化し、その損失を小さくするように重みなどを更新する。学習方法や調整する値はモデルによって異なる。
ここで、学習から求まる「パラメータ」と、開発者が設定・選択する「ハイパーパラメータ」を区別する。前者にはニューラルネットワークの重みなど、後者には学習率、木の深さ、正則化の強さなどがある。学習率や隠れ層の数が、すべてのモデルに存在するわけではない。
学習用データにだけよく適合し、未知のデータで性能が下がる状態を「過学習」という。学習を長く続ければ必ず性能が上がるわけではない。学習用と検証用の結果を比較し、モデルの複雑さの調整、正則化、学習の早期停止などを検討する。
6.モデルの評価――正解率だけでは判断しない
評価では、目的に合った指標で予測の良し悪しを測る。例えば1,000個の製品のうち990個が良品なら、すべてを良品と答えるだけで正解率は99%になる。しかし、不良品10個をすべて見逃すため、不良品検査としては役に立たない。
不良品を「陽性」とする場合、再現率は実際の不良品のうち検出できた割合、適合率は不良品と判定したもののうち本当に不良品だった割合である。F1値は両者の調和平均だが、見逃しと誤検出の業務上の損失をそのまま表す指標ではない。
混同行列で判定の内訳を確認し、傷の種類、製品、撮影条件ごとの結果も調べる。数値予測ならMAEやRMSEなど、予測誤差を測る指標を選ぶ。誤差の平均だけでなく、大きく外す場面や評価件数の少なさにも注意する。
開発中は検証用データや交差検証で比較し、モデルと設定が決まった後に、未使用のテスト用データで最終評価する。テスト結果を見ながら何度も調整すると、そのテスト用データも実質的に選定に使ったことになり、独立した最終評価ではなくなる。
7.モデルの改善――設定を変える前に失敗を見る
性能が不足する場合は、誤判定したデータを調べる。特定の照明でだけ見逃すなら撮影条件やデータの不足、担当者によって判定が違うならラベルの不整合が原因かもしれない。モデルを大きくする前に、何を学べていないのかを確認する。
改善には、データ追加、ラベル修正、特徴量の見直し、モデル変更、ハイパーパラメータ調整などがある。設定の探索にはグリッドサーチやランダムサーチなどを利用できる。データが限られる場合は交差検証も役立つが、その際も製品単位や時間の関係を保って分割する。
判定しきい値も、見逃しと誤検出のバランスを左右する。検証用データで業務上の条件に合う値を選び、しきい値を含めた最終的な仕組みをテストする。変更内容と結果を記録し、一度に多くを変えて効果が分からなくなることを避ける。
8.モデルのデプロイ――業務で使える形にする
デプロイとは、学習済みモデルを実際に利用できる環境へ配置することである。サーバーのAPIとして提供する方法、工場内のパソコンや端末で推論する方法、一定時間ごとにまとめて処理する方法などがある。学習済みモデルで新しい入力の結果を求める処理を「推論」という。
導入時は、学習時と同じ前処理を再現できることを確認する。画像サイズ、色の並び、数値の尺度などが異なれば、モデル自体が同じでも結果が変わり得る。モデルだけでなく、前処理の設定や実行環境もまとめて管理する。
さらに、処理時間、同時実行数、通信断、入力不備、運用費用を確認する。まず人の検査と並行して結果を記録し、有効性を確かめてから適用範囲を広げる方法もある。判定が難しい場合の人への引き継ぎや、障害時に検査を継続する手順も必要である。
9.モデルのメンテナンス――稼働しているだけでは不十分
運用開始後も、材料、製品、カメラ、照明などの変化によって、入力データの傾向が変わることがある。入力の分布が変化するデータドリフトや、入力と正解の関係が変わるコンセプトドリフトは、性能低下につながり得る。変化を検出したら、原因と実際の影響を確認する。
応答時間やエラー率に加え、入力の品質、予測結果の偏り、人が確認した正解との違いを監視する。正解がすぐには分からない業務では、抜き取り確認や後日判明した結果との照合も必要になる。システムが停止していなくても、判定性能が保たれているとは限らない。
再学習は自動的に性能向上を保証しない。新しいデータの品質を確認し、更新前後を比較してから導入する。データ、前処理、モデル、設定、評価結果の版を管理し、問題があれば以前の版へ戻せるようにする。再学習の判断基準と担当者も決めておく。
開発環境は小さく始める
開発にはPythonがよく使われ、データ処理にはpandasやNumPy、機械学習にはscikit-learn、深層学習にはPyTorchやTensorFlowなどが利用される。最初からすべてを学ぶ必要はなく、扱うデータと課題に合わせて選べばよい。
GPUも必須ではない。小規模な表形式データや簡単なモデルならCPUで試せる場合が多い。一方、大きな画像モデルなどではGPUが学習時間の短縮に役立つ。クラウドを使う場合は、実行時間に応じた費用だけでなく、データの持ち出し条件や保存先も確認する。
まずは対象と条件を絞り、収集、学習、評価、推論までを小さく一巡させる。その結果から、データの不足や運用上の難しさを見極め、投資を広げるか判断する。
まとめ――モデルを作ることと、実用化すること
機械学習モデルの開発では、問題の定義、データ収集、前処理、モデルの選択・構築、学習、評価、改善、デプロイ、保守を繰り返す。学習を実行できたことや、高い正解率が出たことだけで完成とはいえない。
重要なのは、現場を反映したデータを用意し、未知のデータで確かめ、誤判定したときの対応まで設計することである。機械学習を導入する目的は、モデルそのものを作ることではなく、解決したい課題に対して継続的に役立つ仕組みを作ることにある。
参考資料
基本概念や評価方法を詳しく確認したい場合は、次の公式資料が参考になる。
Google:What is Machine Learning?
scikit-learn:Common pitfalls and recommended practices
scikit-learn:Cross-validation
scikit-learn:Metrics and scoring
TensorFlow:Transfer learning and fine-tuning
Google:Production ML systems: Monitoring pipelines